







Separare il ripristino del testo SQL dal ripristino del database
Uno script DBeaver mancante non equivale a dati di database mancanti. L’editor memorizza il testo SQL, mentre il server del database memorizza tabelle e record. Il ripristino di una query può aiutarti a riprendere l’analisi, ma non annulla un’istruzione distruttiva né ripristina le righe eliminate. Identifica il problema riscontrato prima di agire e mantieni il testo SQL recuperato separato da qualsiasi decisione di eseguirlo.
Ad esempio, un elenco di script vuoto dopo aver cambiato area di lavoro può significare che il progetto originale rimane altrove. Un arresto anomalo con un editor aperto non salvato può lasciare un diverso tipo di prova. Una query già eseguita potrebbe essere visualizzata nella cronologia di esecuzione disponibile, ma tale cronologia potrebbe omettere commenti o istruzioni mai eseguite. Definisci se hai bisogno di uno script completo, di un frammento utile o di un ripristino del database.
Conserva gli editor aperti senza eseguirli
Se l’SQL mancante rimane visibile in qualsiasi editor, salvalo immediatamente come script separato. Non premere una scorciatoia di esecuzione durante il tentativo di salvare o copiare testo. Registra la connessione associata, lo schema e il dialetto del database previsto nelle tue note, ma mantieni le password e altri segreti fuori dagli inventari di ripristino. Il contesto di connessione può aiutare a spiegare l’SQL senza diventare parte di un documento condiviso.
Conserva l’area di lavoro accessibile prima di cambiare, pulire la cronologia o reinstallare DBeaver. Registra l’edizione e la versione perché alcuni comportamenti della cronologia differiscono tra edizioni e versioni. Mantieni la tua copia conservata distinta da un’area di lavoro di prova. Non dare per scontato che una connessione appena creata ripristini i vecchi script: una definizione di connessione e il testo che hai scritto sono parti di lavoro separate con percorsi di archiviazione e ripristino diversi.
Controlla l’area di lavoro e il progetto correnti
DBeaver memorizza script e altre informazioni sul progetto locale all’interno di uno spazio di lavoro, che può utilizzare una posizione predefinita o personalizzata. Ispeziona l’area di lavoro e il progetto attivi prima di cercare i file eliminati. Un collegamento, un’impostazione dell’ambiente o un’opzione di avvio modificata di recente può aprire un’area di lavoro diversa. Una vista vuota nell’area di lavoro non dimostra che la cartella dello script precedente sia stata rimossa dall’archivio.
Utilizzare le normali visualizzazioni di progetto e script per verificare ciò che esiste. Controlla il percorso completo di uno script salvato noto e confrontalo con quello mancante. Se un vecchio spazio di lavoro rimane disponibile, conservalo prima di aprirlo o migrarlo. Un’area di lavoro copiata può aiutarti a ripristinare i file di script esistenti senza modificare l’ambiente originale o sostituire inutilmente le impostazioni di connessione correnti.
Distinguere uno script da un’esportazione di risultati
Un’esportazione CSV o un foglio di calcolo può preservare i risultati della query, ma normalmente non contiene l’SQL completo che li ha prodotti. Può aiutare a identificare le colonne, i filtri e i valori di output previsti. Trattatela come una prova a sostegno piuttosto che come un sostituto della sceneggiatura originale. La ricostruzione di una query dai risultati è una nuova analisi e richiede la propria convalida, soprattutto quando diverse query potrebbero produrre output simili.
Allo stesso modo, una configurazione di connessione non contiene tutti gli script associati a tale connessione. Un nome di database familiare nel navigatore non è una prova che il testo SQL mancante sia sopravvissuto. Inventaria separatamente gli script salvati, gli editor aperti disponibili, la cronologia di esecuzione, i risultati esportati e gli archivi di progetto. Ciò rende chiaro il passaggio successivo e impedisce di confondere una connessione ripristinata con il ripristino del lavoro di analisi effettivo.
Metodo gratuito 1: trova i file di script salvati esistenti
Esamina la cartella Scripts nel progetto pertinente e la posizione effettiva del filesystem utilizzato da quell’area di lavoro. Utilizzare un nome file distintivo o una frase dell’SQL per identificare i candidati. Conservare copie di file plausibili prima di aprirli. Uno script potrebbe essere stato salvato in un altro progetto, esportato in una cartella separata o rinominato durante la pulizia senza essere eliminato.
Aprire un candidato copiato come testo e confermarne lo scopo prima di assegnarlo a una connessione. Confronta nomi di tabelle, parametri, commenti e logica riconoscibile. Non giustiziare il candidato semplicemente per identificarlo. Uno script storico può contenere istruzioni che modificano i dati, vecchia sintassi specifica del server o presupposti che non sono più validi. L’ispezione del testo dovrebbe stabilire cosa hai recuperato prima che si verifichi qualsiasi interazione con il database attivo.
- Conferma l’area di lavoro attiva e controlla la cartella degli script del progetto pertinente.
- Cerca nelle copie esistenti dell’area di lavoro conservate il nome file mancante o il testo SQL distintivo.
- Copia i file di script plausibili in una cartella di ripristino separata e controllali senza eseguirli.
- Registra la fonte, il dialetto e la completezza di ciascun candidato prima di scegliere la versione accettata.
Confronta attentamente versioni di script simili
Due file possono condividere un titolo pur contenendo filtri o schemi di destinazione diversi. Confronta la query completa e tutte le istruzioni di installazione circostanti. Una piccola differenza nel limite di date, nell’unione o nella regola di esclusione può modificare sostanzialmente l’analisi. Mantieni la versione corrente e quella candidata più vecchia fianco a fianco finché non capisci quali parti appartengono allo script recuperato.
Se unisci le versioni, conserva i candidati originali e salva il risultato unito con un nuovo nome. Segna qualsiasi sezione che hai ricostruito dalla memoria o dalle prove prodotte. Ciò aiuta a separare il testo originale recuperato da nuove ipotesi. Per l’analisi che informa un report o una decisione operativa, questa distinzione è importante quanto il recupero di un file con l’estensione prevista.
Metodo gratuito 2: salva il contenuto dell’editor sopravvissuto
Controlla tutte le finestre aperte di DBeaver e le schede dell’editor per il testo mancante. Una scheda può essere staccata, nascosta tra molti editor o associata a un altro progetto. Se sopravvive del testo utile, salva una copia separata tramite il flusso di lavoro di salvataggio dello script. Conferma la destinazione e controlla il file risultante in un nuovo confronto di sola lettura o in una visualizzazione di testo separata prima di chiudere l’editor originale.
Per un buffer dell’editor parziale, copiare l’intero testo disponibile, inclusi commenti e dichiarazioni di parametri. I dettagli circostanti possono spiegare come doveva essere eseguita la query. Evita di formattare o sostituire i segnaposto finché non avrai preservato lo stato originale. Un frammento può comunque essere prezioso, ma il suo contesto determina se rappresenta uno script eseguibile completo o solo una parte di una sequenza più ampia.
Proteggi le note di analisi non salvate
Gli editor SQL spesso contengono commenti esplicativi, query alternative e ragionamenti intermedi mai eseguiti. La cronologia delle esecuzioni potrebbe non preservare quelle parti. Se l’editor rimane aperto, dai la priorità al salvataggio prima di indagare su un percorso di recupero più elaborato. Il valore di uno script può risiedere nel motivo per cui è stato scelto un filtro, non solo nell’istruzione SELECT finale.
Se non esiste un buffer sopravvissuto, non dare per scontato che ogni scheda non salvata disponga di una copia permanente del disco. Cerca i file conservati effettivi o il comportamento di ripristino supportato nella versione installata. Conservare innanzitutto l’area di lavoro ed evitare modifiche speculative dei dati interni del workbench. Un normale file di script è più semplice da ispezionare e convalidare rispetto a un frammento incerto estratto dallo stato dell’applicazione, quindi utilizzare fonti dirette sopravvissute quando possibile.
Metodo gratuito 3: ispeziona la cronologia delle query disponibili
Il Query Manager di DBeaver può mostrare le query eseguite e le informazioni sull’esecuzione associate, soggette a edizione, impostazioni, conservazione e versione. Controlla la cronologia effettivamente esistente nella sessione e nell’ambiente correnti. Non dare per scontato che la Community Edition conservi la stessa cronologia dei riavvii incrociati di un’edizione a pagamento. Una query utile potrebbe essere ora disponibile anche se non rimarrà dopo un riavvio.
Filtra la cronologia disponibile per connessione, ora o altri campi supportati per restringere la ricerca. Copia il testo SQL rilevante in uno script di ripristino separato senza eseguirlo. Conservare l’ordine originale e annotare la fonte. La cronologia delle esecuzioni può fornire un’istruzione mancante, ma potrebbe non includere testo non eseguito, commenti esterni alla selezione eseguita o tutto il contesto necessario per riprodurre l’analisi originale.
Non riprodurre la cronologia automaticamente
Un elenco cronologico può contenere esperimenti falliti, affermazioni ripetute e operazioni distruttive. Non selezionare l’intero elenco ed eseguirlo come collegamento di ripristino. Leggi ogni affermazione e classificane prima lo scopo. Anche una query che ieri era sicura potrebbe avere come target uno schema predefinito diverso oggi. Il salvataggio del testo è la fase di ripristino; decidere se eseguirlo è un’azione rivista separata.
Distinguere inoltre l’SQL così come scritto da eventuali parametri o valori forniti durante l’esecuzione. Una dichiarazione recuperata con segnaposto potrebbe non contenere i valori che hanno prodotto un particolare report. Utilizzare note esistenti legittime o contesto di esecuzione registrato, ove disponibile. Se mancano i valori, documenta quell’incertezza invece di inventarli. Una query plausibile non è sufficiente per stabilire un risultato storico riproducibile.
Utilizza archivi di progetto esistenti o controllo versione
Se hai esportato un progetto o script già con versione, controlla la revisione dell’archivio o del repository pertinente in una posizione separata. Verificare che contenga file SQL effettivi anziché solo definizioni di connessione. Confronta il contenuto del suo script con le esigenze attuali e con eventuali frammenti di storia sopravvissuti. Un’istantanea del progetto coerente può ripristinare un’organizzazione utile, ma potrebbe comunque omettere il lavoro recente dell’editor non salvato.
Evitare di sostituire l’intero spazio di lavoro attivo solo per recuperare uno script. Ciò può modificare preferenze e connessioni non correlate. Estrai prima i file necessari, quindi importali tramite il normale flusso di lavoro, se necessario. Mantieni le credenziali e l’archiviazione sicura separate da qualsiasi articolo, report o pacchetto di ripristino condiviso. L’obiettivo del recupero è il testo della sceneggiatura e il suo contesto documentato, non l’esposizione di materiale di connessione privata.
Comprendere le possibilità della storia locale senza assumerle
Alcuni flussi di lavoro DBeaver ereditano funzionalità di gestione delle risorse dalla piattaforma sottostante, ma la loro visibilità e il loro comportamento possono dipendere dalla versione e dalla vista installate. Se viene visualizzata un’azione della cronologia locale supportata per lo script salvato, controlla i suoi stati conservati su una copia conservata. Non promettere che ogni script o editor non salvato abbia tale cronologia semplicemente perché lo fa un’altra applicazione basata su piattaforma.
Utilizza solo gli stati effettivamente disponibili e confronta i loro contenuti. Se non viene offerta alcuna storia o non sopravvive nessuno stato rilevante, registra il risultato e utilizza le altre fonti. Evitare di trapiantare file di metadati arbitrari tra aree di lavoro. Lo stato interno non è un archivio di script portatile e una riparazione speculativa dei metadati può rendere più difficile l’interpretazione dell’area di lavoro senza recuperare l’SQL mancante stesso.
Convalidare prima l’SQL recuperato come testo
Leggi la sceneggiatura completa dall’inizio alla fine. Controlla commenti, limiti delle istruzioni, identificatori tra virgolette, parametri e comandi di transazione. Un file può contenere la query desiderata ma all’inizio manca un’importante istruzione di configurazione. Un altro candidato potrebbe terminare a metà di una stringa o di un blocco. Contrassegna le sezioni incomplete e preservale come ripristino parziale anziché considerare lo script come pronto per l’esecuzione.
Identificare il dialetto e la versione del database previsti. SQL simili possono avere significati diversi tra i sistemi, in particolare per quanto riguarda l’aritmetica delle date, gli oggetti temporanei, le virgolette e l’impaginazione. Un controllo della sintassi o un’anteprima della formattazione possono aiutare con la struttura, ma non dimostrano la correttezza analitica. Confronta la logica con lo scopo registrato, inclusa la popolazione, l’intervallo temporale e la granularità prevista del risultato.
Esaminare separatamente le dichiarazioni di modifica dei dati
Se lo script recuperato include INSERT, UPDATE, DELETE, modifiche allo schema o comandi amministrativi, isola tali sezioni per la revisione. Non confrontarli con la produzione come test di completezza. Utilizzare un ambiente usa e getta appropriato o una copia di prova approvata quando è necessaria l’esecuzione. Una strategia di rollback può essere utile, ma non tutte le operazioni si comportano in modo identico all’interno di una transazione tra sistemi di database.
Controllare la connessione selezionata e lo schema predefinito prima di qualsiasi esecuzione consentita. Una scheda dell’editor visivamente familiare può essere associata a una connessione diversa dopo una modifica o un’importazione dell’area di lavoro. Conferma la destinazione in modo esplicito e utilizza l’accesso di sola lettura, ove appropriato, per l’analisi. Il recupero dell’esatto testo originale non stabilisce che il suo precedente obiettivo di esecuzione rimanga corretto oggi.
Riprodurre un’analisi con prove controllate
Per una query di reporting recuperata, confrontare la struttura dei risultati prevista con un’esportazione precedente nota. Controlla i nomi delle colonne, il raggruppamento, i limiti delle date e il conteggio delle righe, ove significativo. Le differenze possono riflettere modifiche dei dati sottostanti piuttosto che un ripristino errato, quindi registrare l’istantanea o il periodo di dati utilizzato per il confronto. Evita di rivendicare l’equivalenza storica quando hai eseguito il test solo rispetto a un set di dati in tempo reale appena modificato.
Se sopravvive solo l’esportazione dei risultati, ricostruisci la query in un nuovo file ed etichettala come ricostruzione. Utilizza l’esportazione per dedurre i requisiti, ma verifica i presupposti con la conoscenza legittima dello schema e la documentazione esistente. Diverse query possono produrre lo stesso campione visibile pur differendo nei casi limite. Testare valori nulli, join duplicati e date limite prima di accettare la nuova analisi come sostituto dell’originale.
Mantieni una traccia di controllo dei frammenti uniti
Quando uno script proviene da diverse fonti, registra quale sezione proviene da un file salvato, da un editor aperto o dalla cronologia di esecuzione. Mantieni visibili i segnaposto non risolti. Ciò rende pratica la revisione e impedisce a un lettore successivo di confondere un valore dedotto con prove recuperate. Una breve nota a fianco della sceneggiatura può spiegare sia cosa è sopravvissuto sia cosa necessita ancora di conferma.
Dopo la revisione, salva uno script accettato pulito e conserva i candidati grezzi separatamente. Includere una descrizione non segreta del ruolo di connessione previsto e dei parametri richiesti. Non incorporare password semplicemente per rendere autonomo il pacchetto di ripristino. L’obiettivo è un’analisi riproducibile all’interno dei normali controlli di accesso, con un contesto sufficiente per eseguire il testo giusto rispetto ai dati approvati giusti, quando appropriato.
Recupera una query di report con parametri mancanti
Una query recuperata può sembrare completa anche se mancano i valori dei parametri che ne definivano il risultato originale. Identifica intervalli di date, filtri dell’organizzazione, ipotesi valutarie e altri input prima della convalida. Utilizzare note di report esistenti legittime o contesto di esecuzione salvato, ove disponibile. Se un valore è sconosciuto, lasciarlo esplicitamente irrisolto nella copia di ripristino. Indovinare una data plausibile può produrre un rapporto convincente che non riproduce l’analisi originale.
Confronta attentamente il comportamento al confine. Una query che include il primo momento del giorno successivo può differire da una che si interrompe alla fine del giorno precedente, anche quando la maggior parte delle righe corrisponde. Registra il fuso orario e il periodo dati previsti quando influiscono sul significato. Si tratta di una convalida dell’analisi piuttosto che di un controllo dell’integrità del file, ma è necessaria se il testo recuperato supporterà una decisione o un risultato pubblicato.
Esaminare gli oggetti temporanei e le dipendenze della sessione
Alcuni script dipendono da tabelle temporanee, variabili di sessione o istruzioni di installazione create in precedenza nell’editor. La cronologia delle esecuzioni può ripristinare la query finale senza tali prerequisiti. Leggi la sequenza completa e identifica cosa deve esistere prima dell’esecuzione di ciascuna istruzione. Conserva i frammenti recuperati nell’ordine osservato, ma non dare per scontato che ogni affermazione precedente nella storia appartenga alla stessa sessione di analisi.
Se ricostruisci la logica di configurazione mancante, salvala come una nuova sezione rivista e spiega il presupposto. Testarlo su un set di dati controllato appropriato. Uno script che viene eseguito solo perché la sessione corrente del database contiene già un vecchio oggetto temporaneo non è ancora riproducibile. Avvia un contesto di test pulito quando possibile in modo che lo script accettato dimostri le sue effettive dipendenze anziché fare affidamento su avanzi invisibili.
Convalida join e granularità dopo l’unione delle versioni
La combinazione di frammenti di candidati diversi può modificare accidentalmente il livello di dettaglio. Un’unione che duplica le righe può lasciare che i totali sembrino plausibili per un piccolo campione producendo nel complesso aggregati errati. Controlla l’unicità delle chiavi, il numero di righe previsto e i casi limite rappresentativi. Confronta l’unità prevista del risultato, ad esempio una riga per ordine o una riga per cliente, prima di accettare una query unita.
Conserva una piccola nota di convalida con lo script accettato che descrive tali aspettative. Non è necessario che espongano dati privati; può indicare le verifiche strutturali ed il campione controllato utilizzato. Ciò offre ai futuri revisori un motivo per fidarsi dell’analisi recuperata oltre al fatto che il file si apre. Aiuta inoltre a distinguere le modifiche successive nei dati sottostanti da un errore introdotto durante la ricostruzione dell’SQL.
Archivia i candidati grezzi separatamente dagli script approvati
I frammenti della cronologia di esecuzione possono includere tentativi falliti e istruzioni distruttive obsolete. Conservarli in un archivio di ripristino chiaramente separato dopo aver estratto lo script accettato. Non inserire tutti i candidati nella normale cartella dello script di produzione senza etichette. Un futuro utente dovrebbe essere in grado di identificare l’analisi rivista senza leggere una lunga conversazione di recupero o indovinare quale timestamp rappresenta l’approvazione.
Per lo script accettato, includere una nota concisa e non segreta su scopo, dialetto, parametri richiesti e convalida. Conservare i candidati originali finché il risultato non ha superato la revisione pertinente. Se il database stesso ha subito una perdita di dati, tenere separato il record di ripristino dell’incidente. Un confine netto tra testo recuperato, esecuzione approvata e ripristino dei dati del server impedisce che un passaggio riuscito venga confuso con il completamento di tutti e tre.
Quando vale la pena valutare il recupero dei file cancellati
PandaOffice Drecov può aiutare a cercare uno script SQL o una copia esistente dell’area di lavoro che è stata eliminata dalla memoria leggibile. Non ripristina i record lato server semplicemente recuperando il testo della query. Inoltre, non può garantire la ricostruzione di un editor non salvato che non ha mai raggiunto lo spazio di archiviazione conservato. Utilizza questo percorso quando hai la prova che esisteva un file locale reale e le fonti native non lo forniscono più.
Prima della scansione, interrompi le scritture non necessarie sul volume interessato e preserva i file dell’area di lavoro accessibili. Conserva gli output recuperati su un’altra destinazione integra. Se il dispositivo mostra errori di lettura o disconnessioni, dare la priorità a un approccio di conservazione adeguato anziché a ripetuti esperimenti di applicazione. Per un SSD i cui blocchi eliminati sono già stati eliminati, un nome file SQL familiare potrebbe non portare a un contenuto originale leggibile.
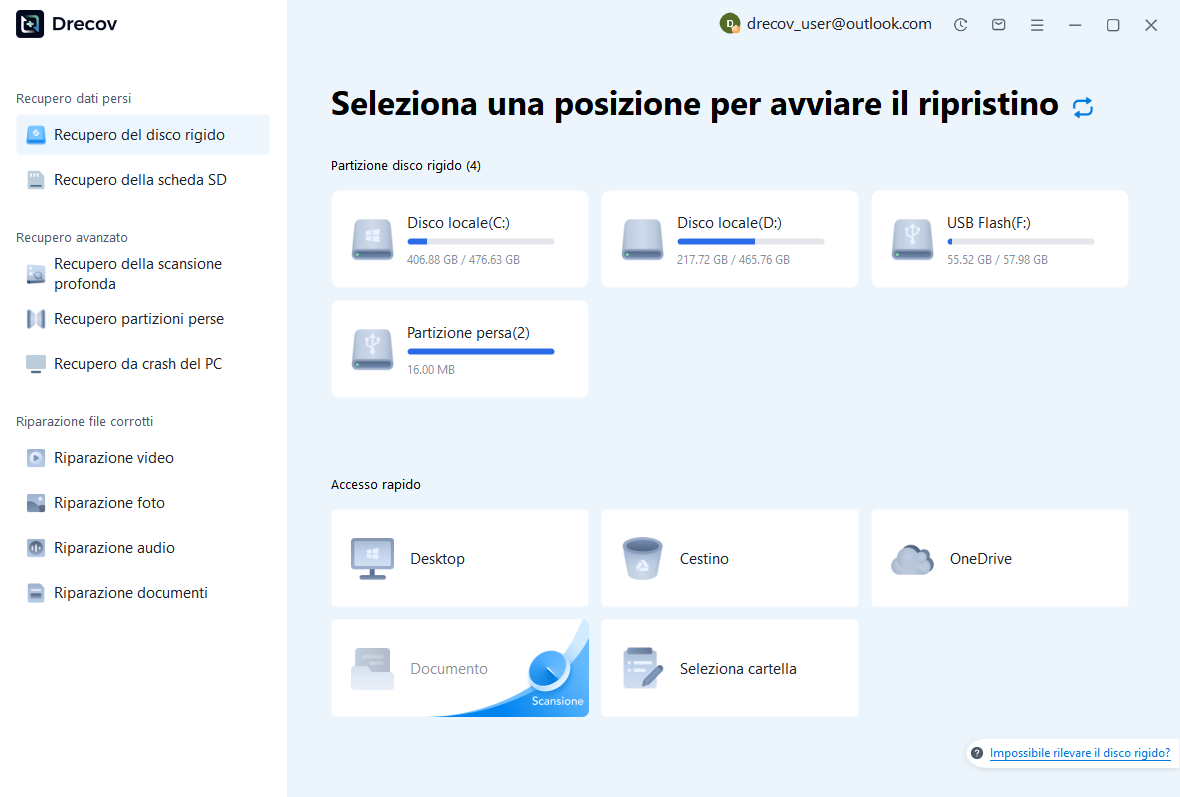
Passaggio 1: selezionare il volume che conteneva lo script
Scegli l’archivio contenente lo script effettivamente salvato o il vecchio spazio di lavoro, non il server del database semplicemente perché lo script si è connesso ad esso. Conferma il percorso locale originale e identifica l’eventuale posizione dell’area di lavoro personalizzata. Evitare di installare software di ripristino su quel volume. Prenota una destinazione protetta separata per i candidati e mantieni le tue note sulle posizioni dei file prive di password o dettagli di connessione sensibili.
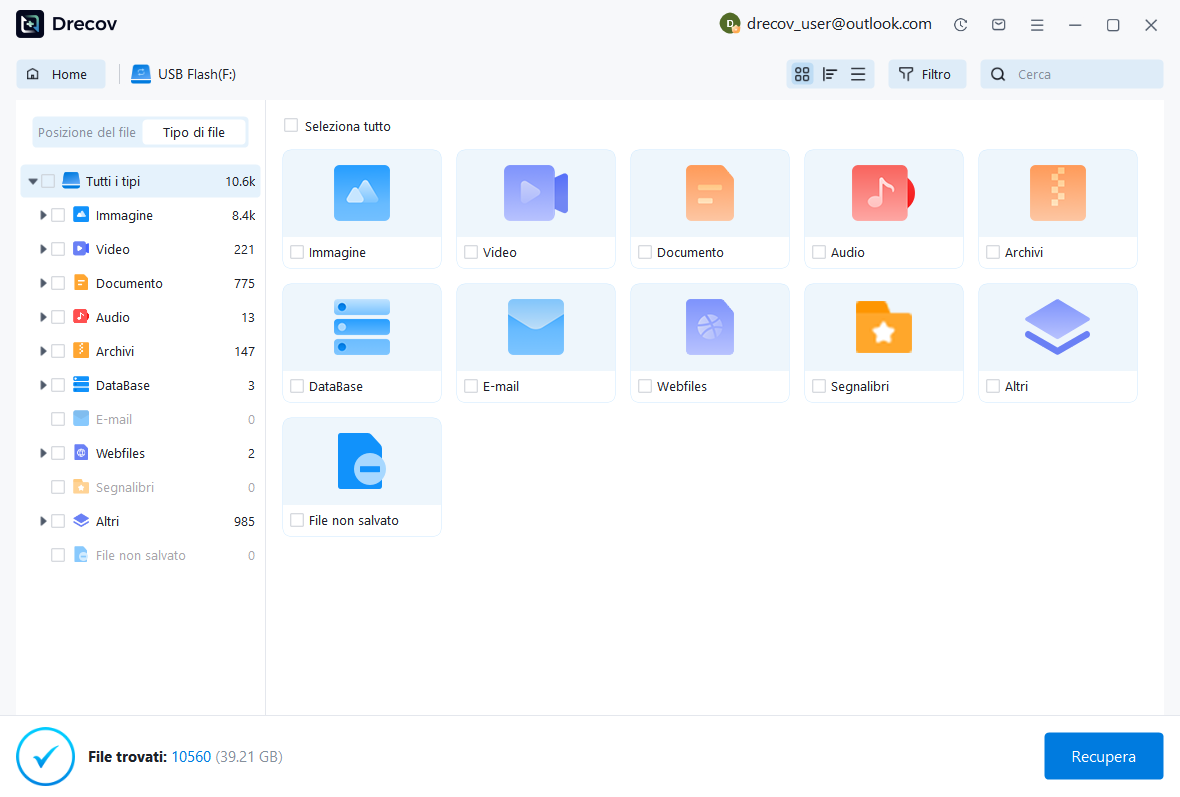
Passaggio 2: rivedere i candidati di testo senza eseguirli
Controlla i percorsi, i nomi, le date, le dimensioni e le anteprime supportate disponibili. Cerca nomi di tabelle o commenti riconoscibili quando possibile. Conserva versioni concorrenti plausibili anziché scegliere automaticamente il timestamp più recente. Un candidato può contenere un esperimento incompleto o solo un frammento eseguito. Conservalo come prova e rimanda tutte le decisioni di esecuzione fino a quando non avrai recuperato e rivisto il testo.
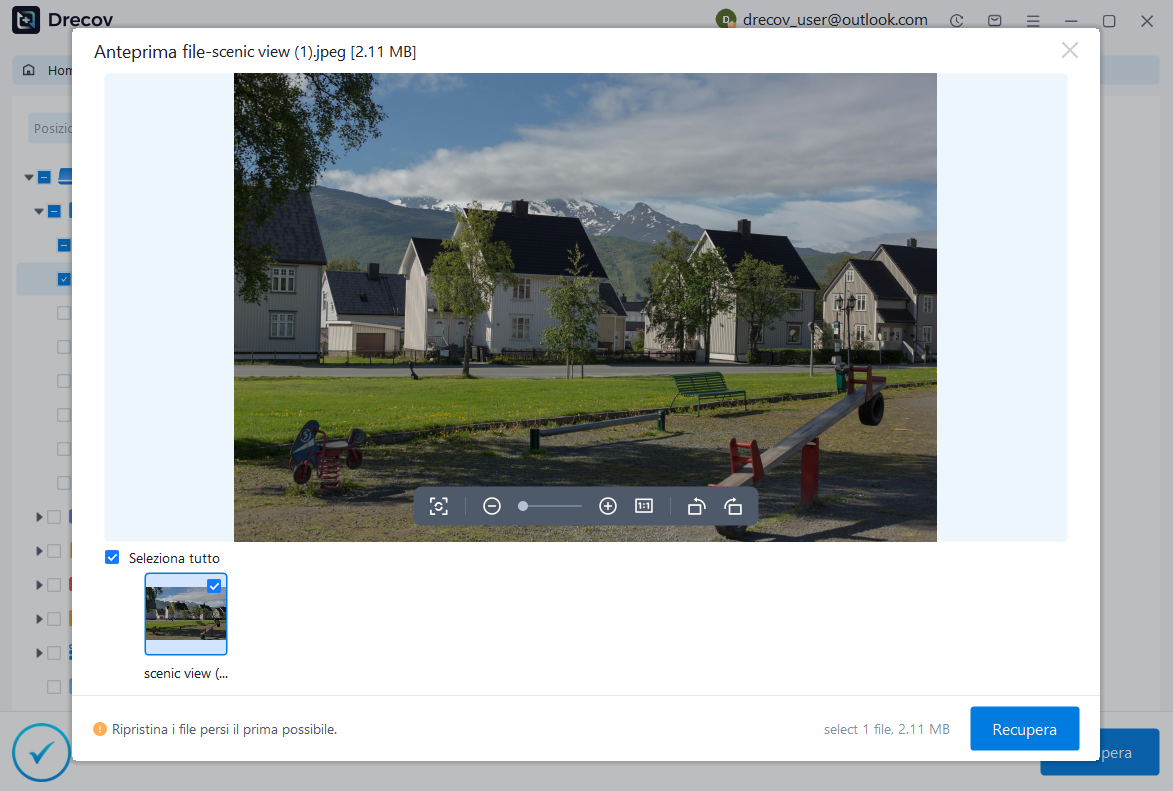
Passaggio 3: ripristina altrove e convalida uno script separato
Salva i candidati in una destinazione separata e controlla le copie in un editor di testo o DBeaver senza eseguirli. Controlla l’inizio, la fine, i parametri e gli estratti conto delle transazioni. Confronta la logica accettata con uno scopo o un output noto. Se è necessaria l’esecuzione, utilizzare l’ambiente controllato e la connessione corretti. Una copia del file riuscita non dimostra che l’SQL recuperato sia completo, aggiornato o sicuro da eseguire.
Completa il recupero con confini chiari
Il record finale dovrebbe distinguere il testo dello script ripristinato, le sezioni ricostruite e qualsiasi incidente del database separato. Se una query ha causato la perdita di dati, il ripristino della query non risolve il problema del database. Mantieni insieme l’SQL accettato e il contesto non segreto e preserva i candidati grezzi finché l’analisi non supera la revisione. Ciò rende il risultato utile senza sopravvalutare ciò che è stato realizzato dal ripristino di uno script locale.
- Conferma la fonte, il dialetto, la completezza e lo scopo previsto della scrittura accettata.
- Esamina i parametri, i presupposti della destinazione e le istruzioni di modifica dei dati prima dell’esecuzione.
- Convalidare la logica rilevante in un ambiente controllato utilizzando prove appropriate.
- Salva lo script revisionato e una copia del progetto indipendente senza credenziali esposte.
Proteggi deliberatamente il futuro lavoro SQL
Salva SQL prezioso come file con nome e eseguine la versione tramite un flusso di lavoro di progetto esistente appropriato. Tratta la cronologia delle query come una comodità di cui hai verificato la conservazione, non come un archivio permanente. Conserva i commenti di analisi e le note sui parametri con lo script. Esegui il backup dell’area di lavoro effettiva o dei file di progetto esportati in base alle tue esigenze e mantieni i backup del database come livello di protezione distinto per i dati lato server.
Infine, prova il recupero di uno script innocuo salvato dalla tua copia indipendente. Verifica che si apra come testo e mantenga commenti e segnaposto senza richiedere una connessione di produzione live. Questo piccolo test verifica che la tua protezione catturi il lavoro che scrivi, anziché solo i nomi delle connessioni o le esportazioni dei risultati. Fornisce inoltre una procedura di recupero calma e ripetibile per l’incidente successivo.
Risorse di ripristino correlate
Esplora le opzioni di ripristino pertinenti: Recupero del disco rigido, Recupero hard disk esterno.
Per un altro caso di recupero e le relative verifiche pratiche, leggere la relativa guida al ripristino.
Controlla le indicazioni del fornitore per la versione installata: documentazione ufficiale di recupero 1, documentazione ufficiale di recupero 2, documentazione ufficiale di recupero 3, documentazione ufficiale di recupero 4.





