







Tratta il ripristino di SQLite come un salvataggio controllato dei dati
Per ripristinare un database SQLite danneggiato, conservare una copia coerente del database e dei relativi file journal, quindi confrontare i backup esistenti prima di utilizzare strumenti di recupero nativi. Non iniziare eliminando un file WAL o eseguendo comandi di pulizia sull’unica origine. Il primo passaggio corretto dipende se il problema è danneggiato, transazioni salvate mancanti, un database bloccato o un’applicazione che prevede uno schema diverso.
Gli strumenti nativi di SQLite possono estrarre dati utili, ma un database recuperato necessita comunque di controlli strutturali e applicativi. Un file che si apre può contenere record mancanti, duplicati o alterati. Pertanto, separare l’estrazione riuscita dall’accettazione del risultato. Questa guida si concentra su copie funzionanti, backup esistenti, stato WAL preservato e salvataggio nativo anziché promettere una ricostruzione perfetta da ogni file danneggiato.
Stabilire una fonte di ripristino coerente
Interrompere la scrittura dell’applicazione nel database interessato tramite il normale processo di arresto o manutenzione, quando appropriato. Se il database deve rimanere attivo, utilizzare un metodo di backup coerente supportato anziché copiare un file che cambia attivamente in modo frammentario. Registra l’applicazione, il percorso del database, l’ambiente SQLite e l’errore esatto. Quindi conserva la fonte prima di aprirla con strumenti che potrebbero modificare lo stato del journal.
Mantieni i sidecar del database corrispondenti esistenti con l’origine, in particolare un file WAL quando presente. Non combinare un database di un tempo con un WAL copiato da un altro stato non correlato. Un backup coerente o uno snapshot di archiviazione è preferibile a una copia casuale di file live. Conservare inoltre una copia separata e intatta in modo che ogni esperimento di recupero parta da prove note anziché dal risultato del tentativo precedente.
Percorso gratuito 1: convalidare un backup coerente esistente
- Individuare un backup esistente supportato dall’applicazione o coerente con SQLite prima dell’errore.
- Ripristinarlo in una directory di test separata anziché nel database di produzione.
- Aprilo con l’applicazione appropriata o l’ambiente SQLite ed esegui i controlli strutturali.
- Confronta record importanti e comportamento dell’applicazione prima di selezionarli come base di ripristino.
Un backup esistente può essere più affidabile del salvataggio di pagine danneggiate, ma la sua età è importante. Confronta gli ultimi record attesi con il tempo di interruzione. Quindi identificare quali transazioni successive mancano. Un database pulito di ieri può essere utile senza essere sufficientemente aggiornato per l’attività prevista. Conservare l’origine danneggiata valutando se i dati validi più recenti possono essere recuperati separatamente.
Controlla l’effettiva identità del backup
Esaminare le tabelle previste e un piccolo set di record noti. Confronta anche qualsiasi versione dell’applicazione o metadati dello schema utilizzati dal software. Un file con l’estensione corretta può appartenere a un altro profilo o a una versione precedente dell’applicazione. Non lasciare che l’applicazione migri l’unico backup prima di conservarlo, poiché la migrazione può modificare la struttura che volevi valutare.
Se esistono diversi candidati di backup, registrarne la provenienza e le tappe fondamentali del contenuto. Ad esempio, nota se viene visualizzata una specifica importazione completata o un record modificato. I tempi di modifica dei file aiutano a ordinare i candidati ma non stabiliscono la completezza della transazione. Il contenuto effettivo del database e le aspettative dell’applicazione determinano se il backup costituisce una base di riferimento adeguata.
Percorso libero 2: preserva uno stato WAL corrispondente
- Conserva un set coerente contenente il database e i file collaterali corrispondenti esistenti.
- Mantieni un set di origini intatto e crea un set di lavoro separato per l’ispezione.
- Aprire il working set in un ambiente SQLite appropriato senza eliminare o sostituire il relativo WAL.
- Verificare i record impegnati previsti e creare un nuovo backup coerente di qualsiasi risultato utilizzabile.
Un WAL fa parte dello stato persistente del database quando contiene transazioni rilevanti. Separarlo dal database può far perdere le modifiche apportate o produrre un risultato incoerente. Tuttavia, trovare un WAL non significa automaticamente che contenga i record mancanti. Il database e WAL devono appartenere insieme e il risultato richiede ancora la convalida. Non allegare un WAL non correlato semplicemente perché il suo nome base è simile.
Non utilizzare la pulizia del journal come prima riparazione
Eliminare sidecar, forzare un checkpoint o modificare la modalità del diario può alterare prove utili. Conservare lo stato originale prima di considerare tali operazioni e utilizzare il processo supportato dall’applicazione quando necessario. Anche un errore di blocco o di occupato non dimostra la corruzione. Determinare se un altro processo conserva ancora il database prima di provare a ricostruirne il contenuto.
Lavora su una directory separata in cui puoi tenere traccia dei file modificati da SQLite durante l’apertura. Quindi confrontare i dati logici con lo stato previsto. Se il working set diventa utilizzabile, crea un output coerente e adeguato anziché copiare solo un file selezionato mentre le connessioni rimangono attive. Ciò preserva un confine chiaro tra la prova originale e un database recuperato accettato.
Percorso gratuito 3: esegui il ripristino nativo di SQLite su una copia
- Ottieni una shell della riga di comando SQLite ufficiale che fornisca la funzionalità .recover.
- Apri una copia funzionante del database danneggiato nella shell.
- Dirige l’output .recover in un nuovo file SQL, mantenendo invariato il database originale.
- Leggi l’SQL in un nuovo database separato e registra tutti gli errori segnalati.
Per un esempio interattivo, avvia sqlite3 con un database copiato denominato working.db. All’interno di quella shell, usa .output recovered.sql, quindi .recover, quindi .output stdout e infine .quit. Questi sono comandi separati immessi uno alla volta. Successivamente avvia sqlite3 con una nuova destinazione denominata recovered.db e utilizza .read recovered.sql. Scegli i nomi di output non utilizzati in modo che un tentativo di ripristino precedente rimanga disponibile per il confronto.
Esaminare l’output di salvataggio prima dell’accettazione
Il ripristino nativo tenta di estrarre contenuti utilizzabili da strutture danneggiate. Può anche ripristinare materiale precedentemente eliminato o inserire record incerti in una tabella degli oggetti smarriti. Pertanto, esaminarne l’output e gli errori anziché considerare un comando completato come prova di correttezza. Conserva l’output SQL e le note accanto al database recuperato in modo da poter tracciare ciò che ha fornito il processo di salvataggio.
Per i dati riservati o sensibili all’applicazione, non importare un risultato di salvataggio direttamente nel servizio live. Testatelo separatamente con record e relazioni rappresentativi. La ricomparsa delle righe cancellate o dei valori modificati può avere importanza anche quando il database supera un controllo strutturale. La decisione di accettazione appropriata dipende dal significato dei dati, non semplicemente dal fatto che una query restituisca risultati.
Percorso gratuito 4: esporta il contenuto leggibile in modo selettivo
- Apri solo una copia funzionante con uno strumento SQLite appropriato.
- Identificare tabelle o query che rimangono leggibili senza errori.
- Esporta i record utili con le definizioni delle colonne e le relazioni pertinenti documentate.
- Importali in un database di ricostruzione separato e convalida il risultato.
L’esportazione selettiva può aiutare quando un recupero completo produce troppa incertezza o un’area danneggiata impedisce l’uso ordinario. Tuttavia, potrebbe omettere vincoli, indici, trigger, visualizzazioni o righe illeggibili. Mantieni questo ambito esplicito. Un CSV contenente alcuni record è utile per il recupero dei dati, ma non è un ripristino completo del database originale dell’applicazione.
Preservare tipi e relazioni
L’esportazione del testo può modificare il modo in cui vengono rappresentati i valori, in particolare per valori null, campi binari, date e identificatori numerici. Registra lo schema originale e controlla il comportamento di importazione. Confronta anche le relazioni tra chiave primaria ed esterna, ove pertinente. Una tabella leggibile può diventare fuorviante se i suoi identificatori non si collegano più ai record associati in un’altra tabella.
Ad esempio, gli allegati recuperati potrebbero richiedere righe di metadati che identifichino gli elementi di proprietà. Il ripristino solo dei nomi dei file allegati può lasciare una cartella di file non assegnati. Conserva le prove della relazione e confrontale con i documenti noti. Se non riesci a stabilire una connessione affidabile, etichetta questi elementi come incerti anziché inventare associazioni per far sembrare la domanda completa.
Esegui controlli strutturali sulla copia recuperata
Utilizza PRAGMA integrity_check; nell’ambiente SQLite appropriato per valutare la coerenza strutturale del database recuperato. Quindi utilizzare PRAGMA foreign_key_check; quando le relazioni di chiave esterna sono rilevanti. Registrare i risultati effettivi e gli eventuali errori. Questi controlli rispondono a domande diverse e il superamento di uno non stabilisce che tutte le regole aziendali o applicative siano valide.
Aggiungi controlli che corrispondono al significato dei dati
Confronta i conteggi previsti delle tabelle, gli identificatori importanti e i valori dei record rappresentativi con prove esterne affidabili. Testare anche i join e i flussi di lavoro delle applicazioni che si basano sulle relazioni tra tabelle. Un database può essere coerente internamente pur mancando un’intera importazione recente. Al contrario, un conteggio di righe imprevisto può riflettere il ripristino del materiale eliminato anziché il ripristino riuscito dello stato corrente previsto.
Controlla la codifica del testo, il contenuto binario e i valori richiesti in un esempio che copre i principali tipi di dati dell’applicazione. Quindi ispezionare i casi limite rilevanti, come gli ultimi record prima del fallimento. Ciò rende l’accettazione più significativa rispetto all’esecuzione di una singola query su una tabella conveniente e presupponendo che il resto del database si comporti allo stesso modo.
Distinguere la corruzione da un ambiente incompatibile
Un’applicazione può rifiutare un database valido perché prevede un altro schema, un’estensione richiesta o un formato crittografato. Registra l’ambiente esatto e l’errore prima di selezionare uno strumento di ripristino. Una shell SQLite generica non può necessariamente leggere un database che richiede un’implementazione di crittografia specifica. La modifica del nome del file o l’esecuzione ripetuta del salvataggio non forniranno la chiave o l’estensione mancante.
Mantieni separata la migrazione delle applicazioni
Se un’applicazione più recente propone una migrazione, conservare prima l’origine e testare la migrazione su un candidato separato. Quindi confrontare lo schema risultante e i record importanti. Una migrazione può avere successo modificando il comportamento, quindi merita un proprio controllo di accettazione. Non confondere un file appena migrato con un database storico recuperato intatto.
Esamina anche i problemi di accesso ordinari come autorizzazioni, spazio di archiviazione non disponibile o un altro processo che detiene un blocco. Questi possono impedire l’apertura senza implicare il danneggiamento della pagina. Risolvi il problema di accesso specifico nel normale modo supportato. La ricostruzione di un database valido per risolvere un problema di percorso o di autorizzazione aggiunge inutili incertezze ai dati che potrebbero essere già intatti.
Un recupero funzionato per un catalogo locale danneggiato
Supponiamo che un catalogo locale riporti un errore del database dopo una scrittura interrotta. Conserva un set di origini coerente e confronta prima l’ultimo backup supportato. Identificare se il backup contiene gli elementi importanti più recenti. In caso contrario, eseguire il salvataggio nativo su una copia separata danneggiata e ispezionare i record recuperati anziché sostituire immediatamente il catalogo.
Riconciliare attentamente i record validi
Il backup può fornire uno schema pulito e record più vecchi stabili, mentre il salvataggio fornisce alcune voci recenti. Confronta gli identificatori e le tabelle correlate prima di qualsiasi unione. Non aggiungere ciecamente ogni riga recuperata, poiché i contenuti eliminati o duplicati potrebbero riapparire. Crea un risultato del test separato e registra quali dati provengono dal backup e quali provengono da un salvataggio incerto.
Quindi aprire il risultato in un profilo dell’applicazione di test ed esercitare flussi di lavoro rappresentativi. Controllare la visualizzazione degli elementi, la ricerca, l’accesso agli allegati e la modifica in modo appropriato. Mantenere separate le prove originali e i candidati respinti. Un lancio riuscito è solo una parte dell’accettazione; l’applicazione deve inoltre utilizzare correttamente le relazioni e il contenuto recuperati.
Evita esperimenti distruttivi sull’unica fonte
Non iniziare con VACUUM, riscritture di schemi o comandi di pulizia sull’originale danneggiato. Tali operazioni possono modificare pagine o rimuovere informazioni che potrebbero essere utilizzate da un altro tentativo di ripristino. Conserva l’originale e utilizza una nuova copia di lavoro per ogni approccio distinto. Conserva l’output dei comandi e i nomi dei candidati in modo che un esperimento fallito non diventi una nuova linea di base inspiegabile.
Conoscere i limiti del salvataggio delle pagine
Le pagine mancanti o sovrascritte possono rendere alcune informazioni permanentemente non disponibili. Il salvataggio nativo può anche recuperare valori senza un contesto sufficiente per identificare in modo affidabile la tabella originale. Indica queste lacune invece di riempirle con ipotesi. Un set di dati verificato più piccolo può essere più utile di un output più grande i cui record non possono essere considerati attendibili o associati correttamente.
Se il database supporta importanti decisioni operative, chiedere al proprietario responsabile dei dati di rivedere i criteri di accettazione. I controlli tecnici stabiliscono leggibilità e coerenza, mentre il proprietario può confrontare il contenuto con i record del mondo reale che rappresenta. Questa è una divisione pratica del lavoro di verifica, non un motivo per affermare che un database strutturalmente pulito debba essere accurato.
Definire l’accettazione a livello di record prima di unire il recupero
Scegliere record rappresentativi che stabiliscano se il database recuperato contiene lo stato previsto. Includere un record più vecchio noto, un record recente e una relazione che coinvolge un’altra tabella. Quindi confrontare i loro valori con prove applicative affidabili. Ciò trasforma una vaga affermazione di recupero riuscito in un controllo concreto del contenuto e aiuta a identificare un database dall’aspetto pulito in cui mancano ancora importanti transazioni recenti.
Confronta identificatori e valori insieme
Un identificatore di record familiare non garantisce che i valori associati siano sopravvissuti correttamente. Ispeziona testo importante, campi numerici, valori null e riferimenti binari, ove pertinente. Quindi controlla le righe correlate. Un record principale può sopravvivere mentre le righe secondarie scompaiono oppure una riga salvata può perdere la relazione che le conferisce significato. Mantieni separate le associazioni incerte anziché inventare collegamenti per rendere completa la visualizzazione dell’applicazione.
Quando si riconcilia un backup pulito con le righe recenti salvate, documentare l’origine di ciascun gruppo importato. Confronta le chiavi prima dell’inserimento e ispeziona i potenziali duplicati. Non dare per scontato che tutti i record assenti dal backup siano nuovi record validi; il salvataggio può far rivivere il contenuto precedentemente eliminato. Un’unione controllata dovrebbe preservare la linea di base pulita e creare un risultato di test separato che è possibile verificare prima di sostituire qualsiasi database funzionante.
Esamina gli oggetti dello schema e le righe della tabella
Un database applicativo utilizzabile può fare affidamento su indici, visualizzazioni, trigger, vincoli e metadati oltre a record visibili. Inventariare lo schema previsto in un backup noto o in un riferimento all’applicazione supportata. Quindi confrontare il candidato recuperato. Gli oggetti dello schema mancanti possono causare errori o modificare il comportamento anche quando una semplice query su una tabella ha esito positivo, quindi registrare le differenze prima di testare l’applicazione.
Distinguere un indice mancante dai dati logici mancanti
Alcuni danni possono influenzare le strutture di accesso senza distruggere tutti i record sottostanti, mentre altri danni rimuovono il contenuto stesso. Non dedurre l’ambito da un messaggio di errore. Esamina i risultati del controllo nativo e confronta i dati leggibili su una copia di lavoro. Qualsiasi azione di ricostruzione dovrebbe avere un obiettivo chiaro e una fonte preservata, perché una riscrittura ampia può modificare le prove senza risolvere il problema dell’applicazione reale.
Esamina anche i metadati dell’applicazione che identificano la versione dello schema o la proprietà del profilo. Un database tecnicamente valido di un altro profilo potrebbe non essere adatto anche se i nomi delle tabelle corrispondono. Conservare il contesto previsto dell’applicazione nel record di accettazione. Ciò evita di promuovere un candidato strutturalmente pulito ma semanticamente sbagliato semplicemente perché si apre in un browser SQLite generico.
Interpretare con cautela i contenuti degli oggetti smarriti
Il salvataggio nativo può estrarre record che non è possibile associare con sicurezza alla tabella originale. Conserva l’output, ma non inserirlo immediatamente nella tabella con un numero simile di colonne. Confronta tipi, identificatori e contenuti noti e mantieni isolate le righe incerte. Il contesto strutturale mancante può essere importante quanto gli stessi valori recuperati.
Registrare l’incertezza al più piccolo ambito utile
Potresti essere in grado di verificare un elemento recuperato lasciandone un altro irrisolto. Mantieni queste decisioni separate. Ad esempio, il corpo di una nota riconoscibile può essere utile come recupero di testo anche quando non è possibile stabilire la relazione con la cartella originale. Etichettatelo di conseguenza invece di assegnarlo a un luogo inventato. Ciò preserva informazioni preziose senza trasformare l’incertezza in uno stato dell’applicazione fuorviante.
Se il proprietario dei dati può confrontare il recupero con documenti autorevoli, fornire un elenco chiaro di candidati e i dettagli relativi alla fonte. Conservare l’output SQL intatto e le copie del database come prova. Una revisione successiva potrebbe risolvere un’associazione che al momento non è chiara, e preservare il materiale grezzo di recupero impedisce che una decisione tempestiva sulla ricostruzione diventi l’unica interpretazione rimanente.
Testare l’applicazione in un profilo o un’area di lavoro separata
Dopo i controlli strutturali, utilizzare un ambiente non di produzione supportato per ispezionare il database recuperato. Il rappresentante dell’esercizio legge e modifica i flussi di lavoro, quindi confronta i record risultanti. Ciò rileva le aspettative che un controllo SQLite generico non può esprimere, come i metadati richiesti o le relazioni imposte dalla logica dell’applicazione. Mantenere le modifiche dell’ambiente di test separate dal candidato di ripristino accettato.
Ispezionare il comportamento dopo la riapertura
Chiudere normalmente l’applicazione del test e riaprire lo stesso candidato. Quindi ispezionare nuovamente i documenti importanti. Alcuni problemi compaiono solo quando l’applicazione salva lo stato, ricostruisce una cache o ricarica le relazioni. Un singolo lancio riuscito è quindi un test di accettazione incompleto. Registra eventuali nuovi avvisi e confronta lo stato del database prima di decidere se il candidato è pronto per l’uso continuato.
Infine, crea un backup coerente supportato del risultato accettato e testalo in modo indipendente. Conservare separatamente la fonte originale danneggiata, i sidecar corrispondenti, l’output di recupero e le note di accettazione. Se il recupero rimane parziale, identificare chiaramente le registrazioni mancanti o incerte. Ciò fornisce una base operativa affidabile preservando al contempo le prove necessarie per qualsiasi successiva ricostruzione o indagine specialistica.
Mantieni il recupero dei file separato dall’accettazione della transazione
Un nome file di database recuperato è un input per la valutazione logica, non una dichiarazione che ogni transazione è sopravvissuta. Confrontare i record e le relazioni effettivi che definiscono lo stato dell’applicazione previsto. Quindi registra quali test sono stati superati e quali lacune rimangono. Questa distinzione è particolarmente utile quando la scansione di un file fornisce a diversi candidati date plausibili ma contenuti diversi o un contesto collaterale incompleto.
Conserva passaggi di ripristino ripetibili
Utilizzare una nuova copia di lavoro per ciascun approccio di recupero distinto e registrare i nomi degli output. Mantieni la versione dello strumento e le opzioni pertinenti insieme ai risultati. Quindi confronta i candidati utilizzando gli stessi controlli a livello di record. Ciò rende l’indagine riproducibile e impedisce che un miglioramento apparente dipenda da una modifica non documentata apportata durante un precedente tentativo fallito.
Se alla fine si sceglie un backup più vecchio e pulito rispetto a un risultato di recupero più ampio, indicare il motivo. Relazioni verificate e contenuto noto possono essere più utili di ulteriori righe incerte. Conservare il recupero separatamente per una revisione successiva anziché forzare ogni valore estratto nel database accettato. Ciò fornisce una base di riferimento affidabile pur conservando informazioni potenzialmente preziose che necessitano ancora di interpretazione.
Quando il recupero dei file cancellati può aiutare i dati SQLite
PandaOffice Drecov è rilevante quando un database salvato, un file journal esistente corrispondente o un backup coerente è stato eliminato dallo spazio di archiviazione accessibile. Non sostituisce gli strumenti di salvataggio logico di SQLite né ricrea transazioni sovrascritte. Ridurre anche le scritture sullo spazio di archiviazione interessato. Se il dispositivo stesso segnala ripetuti errori di lettura, valuta tale condizione prima di eseguire una scansione di routine dei file eliminati.
Passaggio 1: identificare l’archivio del database originale
Scegli l’unità o la partizione che conteneva il database dell’applicazione e la sua effettiva posizione di backup. Registra il nome base originale e tutti i sidecar che esistevano con esso. Conserva l’output di ripristino in un altro spazio di archiviazione integro. Evitare di avviare l’applicazione nella posizione interessata semplicemente per generare un altro errore, poiché ciò potrebbe creare nuovi file o modificare lo stato del diario sopravvissuto.
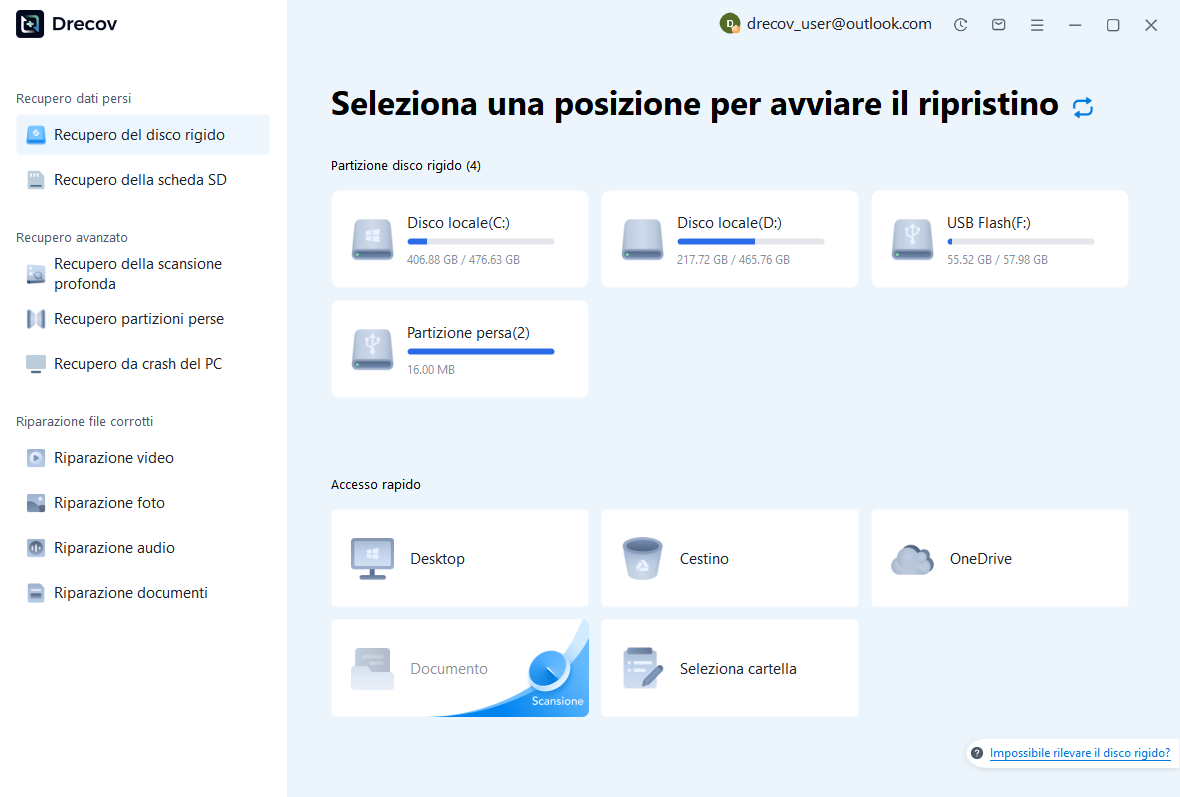
Passaggio 2: raccogliere candidati coerenti per il database
Esamina i nomi, i percorsi, le dimensioni e le date disponibili per il database e i file correlati. Conserva diversi candidati plausibili senza combinare versioni non correlate. Una scansione non può stabilire la coerenza transazionale solo dal nome di un file. Conserva i dettagli dell’origine e tratta i set di database e sidecar recuperati come candidati che necessitano successivamente della convalida di SQLite e dell’applicazione.
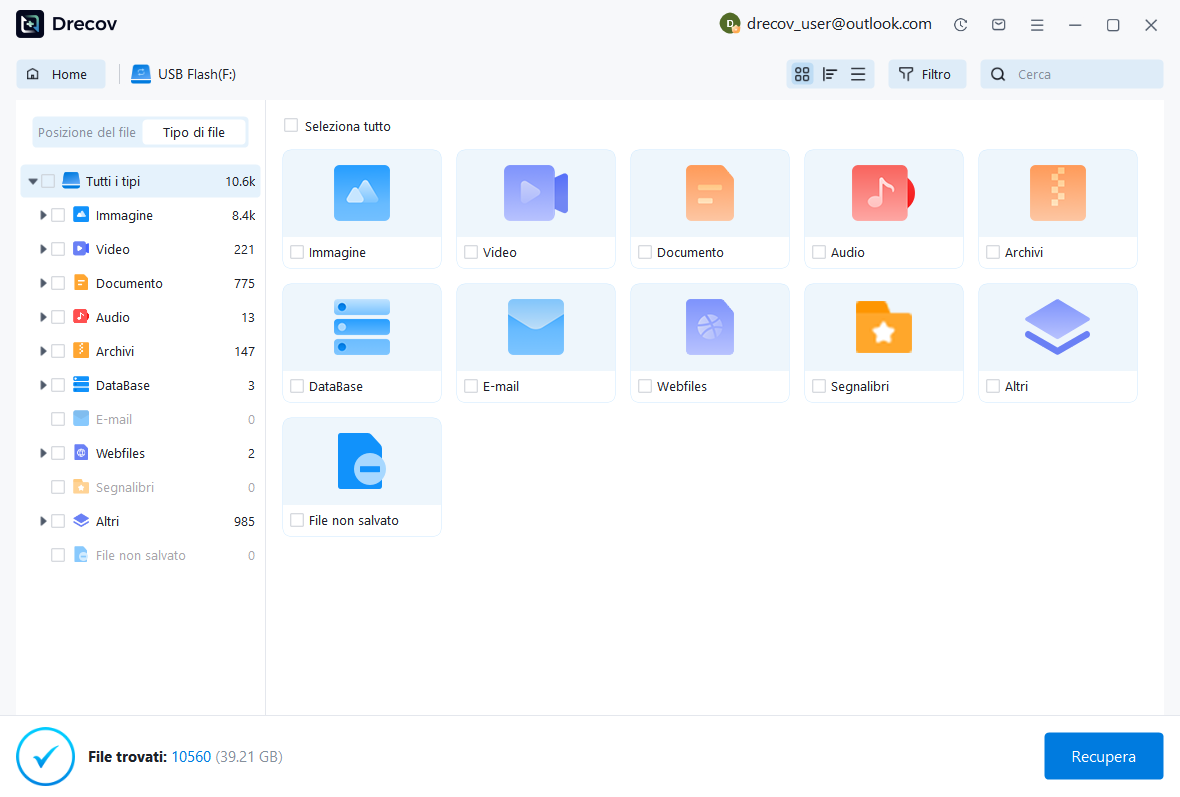
Passaggio 3: ripristinare altrove e convalidare il contenuto logico
Ripristina i file selezionati in una destinazione separata, preserva un set recuperato intatto e controlla un’altra copia funzionante. Confronta i backup esistenti, esegui controlli o salvataggi nativi adeguati e testa record e relazioni importanti. Non restituire un ripristino non convalidato direttamente al servizio. Un nome file completo e un ripristino del file riuscito non dimostrano che le transazioni previste siano sopravvissute.
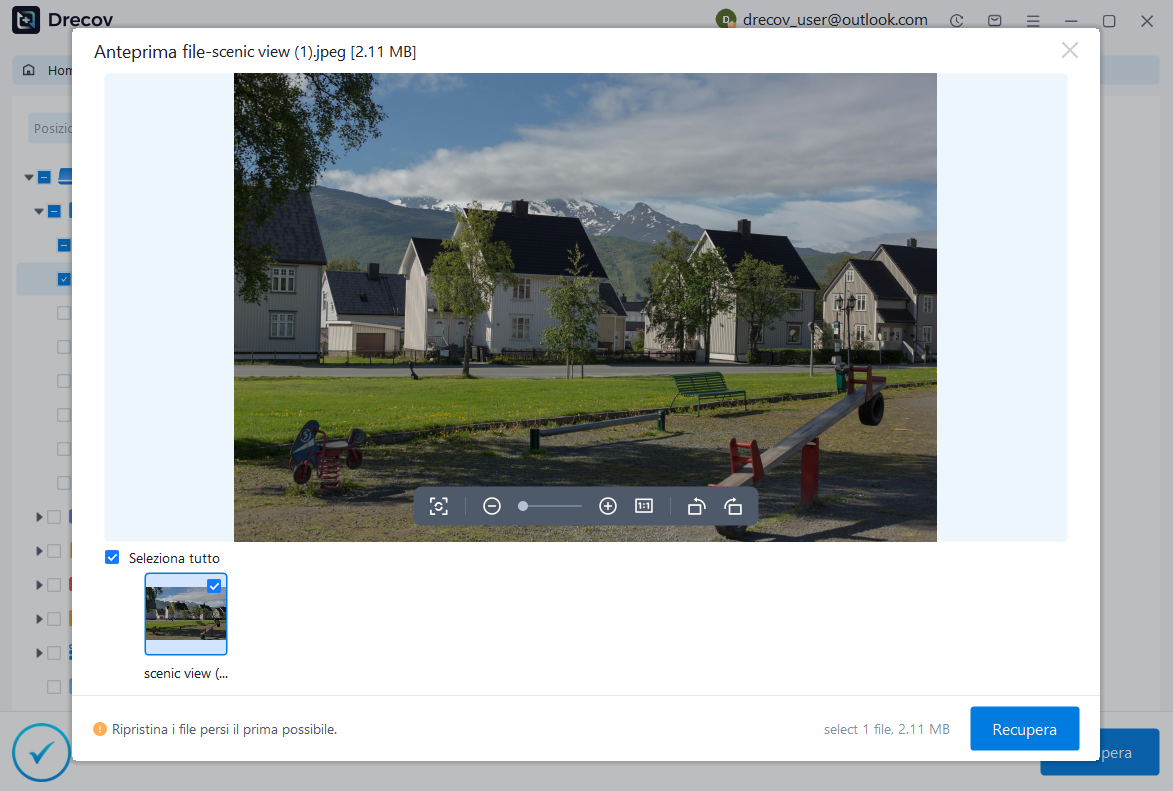
Documentare il database accettato e l’incertezza rimanente
Registrare il candidato sorgente, gli strumenti, i comandi, gli errori, i controlli e i test applicativi utilizzati per il risultato accettato. Mantenere il database recuperato separato dall’output di recupero SQL e dalle prove originali. Quindi crea un backup coerente supportato dello stato verificato. Ciò fornisce alla successiva attività di manutenzione una base di riferimento affidabile invece di una raccolta di copie ambigue del database.
Testare i backup futuri come ripristini effettivi
Utilizza un esempio non di produzione per testare la procedura di backup e ripristino dell’applicazione. Verificare che l’output si apra in modo indipendente e contenga i record recenti previsti. Documenta inoltre il modo in cui l’applicazione utilizza WAL e il luogo in cui appartiene il backup. Un test pratico di ripristino fornisce la prova che la protezione funziona, mentre la semplice copia di un nome file di database visibile può trascurare parte del suo stato persistente.
Se alcuni record rimangono mancanti o incerti, elencali esplicitamente. Un recupero parziale può comunque recuperare informazioni preziose, ma non deve diventare una pretesa incondizionata di restauro completo. Limiti chiari ti aiutano a decidere se ricostruire da altri documenti autorevoli, conservare il risultato come riferimento o continuare un’indagine specialistica.
Risorse di ripristino correlate
Esplora le opzioni di ripristino pertinenti: Recupero del disco rigido, Recupero hard disk esterno.
Per un altro caso di recupero e le relative verifiche pratiche, leggere la relativa guida al ripristino.
Controlla le indicazioni del fornitore per la versione installata: documentazione ufficiale di recupero 1, documentazione ufficiale di recupero 2, documentazione ufficiale di recupero 3, documentazione ufficiale di recupero 4.





