







Un commit Git può scomparire dalla cronologia del ramo visibile mentre i suoi oggetti esistono ancora localmente. Un ramo ripristinato, riprogrammato o eliminato può rimuovere il riferimento conveniente senza cancellare immediatamente ogni oggetto sottostante. Ciò rende gli strumenti di ispezione di Git la prima via di ripristino. Inizia preservando il repository e il lavoro corrente non impegnato. Quindi cerca il commit previsto e crea un nuovo riferimento anziché spostare in modo distruttivo il ramo corrente.
Risposta rapida: ispeziona prima e crea un ramo di salvataggio
Utilizzare il reflog locale pertinente per individuare un commit precedente plausibile, ispezionarne il contenuto e creare un ramo di ripristino denominato separatamente quando il candidato ha ragione. Le scorte esistenti o i cloni sopravvissuti autorizzati forniscono fonti diverse. Se non rimane alcun riferimento, un’ispezione dell’oggetto di sola lettura può rivelare alcuni commit pendenti che esistono ancora. Nessuno di questi percorsi garantisce il ripristino dopo che gli oggetti richiesti sono stati rimossi o quando il lavoro mancante non è mai entrato in Git.
Gli strumenti di ripristino di Git sono gratuiti. Tuttavia, i comandi hanno effetti diversi e un articolo di ripristino non dovrebbe incoraggiare un altro hard reset come primo passo. Preserva lo stato di funzionamento attuale e ispeziona gli esempi prima di adattarli. Distinguere inoltre il lavoro impegnato, il contenuto messo in scena, i file non tracciati, le risorse ignorate e i buffer dell’editor non salvati. Un ripristino del commit può avere esito positivo mentre rimane mancante un file separato non tracciato.
Identificare lo stato Git mancante
Riferimento perduto contro oggetti mancanti
Registra cosa è successo: eliminazione del ramo, rebase, ripristino, sostituzione del repository o directory di lavoro mancante. Un commit assente dal log corrente può rimanere raggiungibile da un altro ramo o tag. Inizia con i riferimenti esistenti prima di cercare oggetti irraggiungibili. Conferma anche il repository e il clone corretti. Due cartelle con lo stesso nome di progetto possono contenere cronologie locali e reflog diversi.
Annotare un messaggio di commit riconoscibile, un percorso modificato, una funzione o un test. Questo ti dà un test pratico di accettazione quando diversi candidati sembrano simili. Un messaggio familiare da solo non è sufficiente perché un rebase può creare diversi commit con descrizioni correlate. Ispeziona le modifiche effettive e la cronologia dei genitori pertinenti. L’obiettivo è lo stato previsto del progetto, non semplicemente un identificatore di oggetto che assomigli a quello ricordato da uno screenshot del terminale.
Conserva il lavoro corrente e il contesto del repository
Effettuare una copia completa e appropriata del repository evitando modifiche simultanee. Includi i metadati Git rilevanti, non solo i file sorgente visibili. Conserva anche il lavoro non impegnato e non tracciato in modo indipendente. Un clone normale non copia necessariamente i reflog locali o gli oggetti irraggiungibili, quindi non è automaticamente una copia di prova completa per questa indagine. Registra la cartella di origine e la versione Git utilizzata per il test.
Per gli alberi di lavoro collegati, ispeziona la relazione effettiva tra le directory Git prima di copiare solo la cartella dell’albero di lavoro. I suoi metadati Git potrebbero risiedere altrove. Mantieni queste relazioni documentate e utilizza i flussi di lavoro Git supportati. Evitare inoltre comandi di manutenzione che eliminano gli oggetti mentre il ripristino rimane irrisolto. Una nuova build o installazione di dipendenze è solitamente irrilevante per trovare un commit perduto e può aggiungere modifiche non necessarie all’ambiente di lavoro.
Percorso libero 1: ispezionare il reflog locale
- Conferma il repository e conserva il lavoro corrente.
- Esegui un’ispezione del reflog di sola lettura, come git reflog show –all, nel clone pertinente.
- Identificare le voci plausibili relative al ripristino, al rebase o alla modifica del ramo.
- Ispeziona le modifiche effettive di ciascun candidato prima di creare qualsiasi riferimento di recupero.
I relog registrano gli aggiornamenti ai riferimenti locali e possono rivelare dove puntava in precedenza un ramo o un HEAD. Sono prove locali, non una storia universale lato server. Un altro clone può avere voci diverse e la conservazione non è indefinita. Pertanto, ispeziona immediatamente il clone in cui si è verificato l’incidente. Non promettere una finestra di ripristino fissa senza verificare la configurazione effettiva e gli oggetti sopravvissuti.
Leggi attentamente la sequenza degli eventi
Confronta le voci prima e dopo l’operazione che ha modificato la visibilità. Un rebase può generare una serie di stati correlati, mentre un reset può spostare direttamente la punta del ramo. Ispeziona un candidato con un comando come git show seguito dall’identificatore dell’oggetto effettivo. Tratta l’identificatore come un valore da selezionare dal tuo repository, non come un segnaposto da incollare letteralmente. Confronta anche i file interessati e la cronologia principale.
Se più voci contengono la modifica mancante, determinare quale rappresenta la linea di lavoro completa prevista. Un singolo commit può dipendere da commit precedenti inclusi nella cronologia del candidato. Conserva un ramo sulla punta appropriata invece di copiare una patch alla cieca. Ciò mantiene la sequenza di sviluppo recuperata disponibile per la revisione senza forzare lo spostamento immediato del ramo corrente.
Percorso libero 2: creare un riferimento di salvataggio separato
- Ispezionare il candidato e confermare che gli oggetti richiesti rimangono disponibili.
- Scegli un nuovo nome per il ramo di salvataggio non utilizzato.
- Crea il ramo sull’oggetto verificato, ad esempio con git branch e il nome e l’identificatore scelti.
- Ispeziona il nuovo ramo e confrontalo con il lavoro attuale in un’area di lavoro controllata.
La creazione di un nuovo ramo fornisce un riferimento duraturo al candidato senza reimpostare il ramo corrente. Il comando modifica i riferimenti al repository, quindi preserva le prove e seleziona deliberatamente la destinazione. Non unisce automaticamente le modifiche recuperate nella produzione. Mantieni separata la decisione sull’integrazione. Verificare inoltre che il nome scelto non identifichi già un altro ramo utile prima di adattare un esempio di comando.
Un modello di comando è git branch recovery-example COMMIT_ID. Qui, recovery-example rappresenta un nuovo nome di ramo inutilizzato e COMMIT_ID deve essere sostituito con l’effettivo identificatore di commit verificato dal tuo repository. Non incollare il segnaposto letteralmente. Ispeziona prima il candidato con git show e il suo vero identificatore. La creazione di questo ramo di salvataggio preserva un riferimento senza richiedere git reset –hard e non autorizza l’invio o la sostituzione della cronologia remota condivisa.
Rivedere prima dell’integrazione
Confronta il ramo recuperato con la base prevista e il ramo attuale. Esamina test, configurazione, migrazioni e dipendenze associate alla modifica. Un commit può essere autentico pur non adattandosi più all’applicazione attuale. Utilizzare un’area di lavoro di test separata, ove appropriato. Il recupero stabilisce l’accesso ad uno stato storico; la normale revisione ingegneristica determina come integrarlo in modo sicuro nel lavoro attuale.
Non forzare il push della cronologia condivisa semplicemente per far sì che il ramo ripristinato assomigli allo stato remoto precedente. Conservare prima un riferimento di soccorso locale. Qualsiasi modifica alla pubblicazione o alla cronologia condivisa appartiene al normale flusso di lavoro autorizzato del repository. Questa distinzione impedisce che un ripristino locale rimuova accidentalmente il lavoro più recente dei colleghi o esponga contenuti incompleti che necessitavano solo di ispezione.
Percorso gratuito 3: ispeziona una scorta esistente
- Conserva il repository e lo stato di funzionamento attuale.
- Elenca le voci di stash esistenti tramite l’interfaccia supportata di Git.
- Ispeziona una scorta rilevante prima di applicarla.
- Recupera i contenuti verificati in uno stato di test separato senza eliminare l’unico candidato di scorta.
Una scorta può preservare il lavoro che non è mai diventato un normale commit del ramo, ma la sua copertura dipende da come è stato creato. I file non tracciati o ignorati non vengono inclusi automaticamente in ogni scorta. Pertanto, ispeziona i contenuti effettivi anziché dare per scontato che la scorta contenga l’intero spazio di lavoro. Confronta anche il commit di base e i file previsti. Una scorta con nome simile può appartenere a un’altra attività.
Mantenere l’ispezione e l’applicazione separate
L’ispezione dello stash di sola lettura aiuta a identificare un candidato senza modificare l’albero di lavoro. L’applicazione di una scorta può produrre conflitti o sovrascrivere le ipotesi sulla base corrente, quindi utilizzare un’area di lavoro controllata e preservare prima le modifiche attuali. Evita un flusso di lavoro pop-and-drop come test iniziale quando potrebbe consumare il candidato più utile. Conserva la scorta finché il contenuto recuperato non viene verificato e conservato in modo indipendente.
Se una voce stash stessa scompare, i suoi oggetti potrebbero rimanere o meno nel repository. Trattalo come una valutazione separata del ripristino dell’oggetto piuttosto che promettere che lo stesso comando di elenco possa trovarlo. Distingui anche una scorta dalla cronologia dell’editor. Un buffer di origine che non è mai stato salvato o incluso in Git richiede un’altra origine di ripristino, anche quando la cronologia dei commit del repository rimane completamente integra.
Percorso libero 4: ispeziona un clone sopravvissuto autorizzato
- Identificare un clone o un riferimento esistente legittimo che potrebbe contenere il commit mancante.
- Conserva il suo stato locale prima di modificare i riferimenti o recuperarlo.
- Ispezionare la storia e il contenuto effettivi del candidato.
- Trasferisci o fai riferimento al ripristino verificato tramite un flusso di lavoro Git controllato appropriato.
Il clone autorizzato di un collega, un’altra macchina personale o un riferimento remoto esistente possono preservare un commit a cui il clone interessato non fa più riferimento. Tuttavia, un nome di tracciamento remoto non garantisce che lo stato desiderato sottostante rimanga disponibile. Ispeziona gli oggetti reali e la storia. Evitare inoltre di utilizzare il repository privato o le credenziali di qualcun altro senza autorizzazione. L’origine di ripristino deve essere quella che controlli legittimamente o che sei autorizzato a utilizzare.
Confronta l’identità e il contenuto dell’oggetto
Le versioni ribasate della stessa modifica logica possono avere identificatori di oggetto diversi. Al contrario, un prefisso identificativo familiare è solo una scorciatoia che deve risolversi in modo inequivocabile nel repository. Confronta la differenza effettiva e la storia circostante. Registra anche quale clone ha fornito al candidato. Ciò aiuta a spiegare perché la linea recuperata differisce da una voce di reflog locale e mantiene tracciabile l’indagine.
Se il clone contiene un ramo utile, conservare un nuovo riferimento di salvataggio prima dell’integrazione. Non sincronizzare ogni ramo indiscriminatamente come scorciatoia di ripristino. Un trasferimento ristretto della cronologia verificata è più facile da rivedere e ha meno probabilità di confondere lavori non correlati. Successivamente, esegui i test appropriati e controlla la differenza risultante rispetto allo stato del progetto previsto.
Percorso libero 5: ispeziona gli oggetti penzolanti sopravvissuti
- Conserva una copia completa del repository pertinente ed evita la manutenzione della potatura.
- Utilizzare un comando di sola lettura per l’integrità e l’ispezione degli oggetti appropriato per il repository.
- Ispezionare gli oggetti di commit plausibili pendenti e il loro contenuto.
- Crea una nuova referenza solo dopo aver individuato un candidato utile e verificato.
L’ispezione degli oggetti di Git può rivelare commit o altri oggetti che rimangono senza un normale riferimento al ramo. Tuttavia, non può recuperare oggetti già rimossi da ogni fonte disponibile. Inoltre, i BLOB e gli alberi pendenti non preservano automaticamente i nomi dei file, il contesto completo del progetto o una cronologia dei commit pronta all’uso. Trattare l’output come prova da ispezionare, non come una garanzia che ogni oggetto segnalato appartenga all’attività persa.
Non confondere gli avvertimenti con il bersaglio
Un database di oggetti può contenere materiale irraggiungibile non correlato dalla normale attività. Confronta percorsi e contenuti riconoscibili prima di selezionare un candidato. Registrare i messaggi di errore effettivi separatamente dai report informativi sugli oggetti penzolanti. Se il repository presenta un danneggiamento autentico, preservalo e cerca il percorso di riparazione supportato appropriato anziché eseguire comandi di scrittura arbitrari fino alla scomparsa dell’errore.
Conserva le prove del repository originale anche dopo aver trovato un oggetto utile. Un confronto successivo potrebbe rivelare che un altro candidato contiene un test mancante o una modifica di follow-up. Documenta inoltre se il risultato ripristina un’intera sequenza di commit o solo un frammento di origine. Si tratta di risultati diversi e il piano di integrazione dovrebbe riflettere il contesto rimanente che è necessario ricostruire.
Esempio: recuperare un ramo dopo un reset indesiderato
Supponiamo che uno sviluppatore reimposti un ramo di funzionalità su un punto precedente e in seguito si renda conto che due commit utili sono scomparsi dal registro visibile. Il repository contiene ancora i loro oggetti e il reflog di HEAD mostra il suggerimento del ramo precedente. Per prima cosa preserva il lavoro corrente. Ispeziona la cronologia delle differenze e dei genitori del candidato, quindi crea un nuovo ramo di salvataggio nel suggerimento verificato. Il ramo corrente non necessita di un altro ripristino distruttivo per questo primo passaggio di ripristino.
Successivamente, confronta il ramo di salvataggio con il lavoro attuale ed esegui test mirati in un’area di lavoro controllata. Se i colleghi hanno aggiunto modifiche più recenti altrove, integratele attraverso il normale processo di revisione anziché forzare lo stato storico. Infine, conserva il ripristino accettato e documenta la voce di reflog dell’origine. Ciò ripristina l’accesso ai commit previsti mantenendo la decisione di integrazione separata e rivedibile.
Convalidare più del messaggio di commit
Esamina i file modificati, la cronologia principale, i test, la configurazione e le risorse di progetto richieste. Quindi confrontare il candidato con il comportamento effettivamente mancante o con la pietra miliare dello sviluppo. Un commit che viene compilato può ancora rappresentare uno stato intermedio incompleto. Conserva anche il materiale non tracciato separatamente dove l’attività lo richiede. Il ripristino Git può restituire la cronologia registrata lasciando irrisolti i dati ignorati, le impostazioni locali o i buffer non salvati.
Conservare l’archivio delle prove, i riferimenti di salvataggio e l’integrazione accettata fino al termine della revisione. Successivamente, proteggi i rami o le esportazioni significativi attraverso il normale flusso di lavoro di backup. Conserva anche importanti risorse non Git in modo indipendente. Un repository remoto e un reflog locale rispondono a domande diverse, quindi nessuno dei due dovrebbe essere trattato come un backup illimitato di ogni stato che una volta appariva in un editor.
Classificare il lavoro perso prima di scegliere un comando
Stati impegnati e non impegnati
Un suggerimento di ramo può spostarsi mentre gli oggetti sottoposti a commit sopravvivono, ma un file non tracciato potrebbe non entrare mai nel database degli oggetti. I contenuti organizzati e le scorte introducono altre possibilità. Registra il flusso di lavoro effettivo che ha preceduto la perdita. Ciò impedisce che un salvataggio di commit riuscito venga presentato come ripristino di ogni file che una volta appariva nella directory di lavoro. Stati diversi necessitano di prove diverse.
Per il testo mancante non disponibile, controlla la cronologia dell’editor sopravvissuta o le copie indipendenti dell’area di lavoro insieme a Git. Conserva anche le modifiche attuali prima di testare uno stato storico. Non forzare tutte le domande di recupero in una ricerca di reinserimento. Una classificazione chiara ti aiuta a scegliere rapidamente la fonte giusta ed evita comandi distruttivi che spostano il ramo corrente senza affrontare il materiale effettivamente mancante.
Percorsi rinominati e identità del ramo
Un file può apparire mancante perché il suo percorso è cambiato o perché è stato aperto il ramo sbagliato. Ispezionare l’identità del repository, il ramo e la cronologia rilevante prima di presumere una perdita di dati. Confronta anche la differenza effettiva attorno a una ridenominazione. Una sola ricerca per nome file potrebbe perdere contenuti utili in un altro percorso. Mantieni il comportamento previsto e il frammento di origine distintivo nella tua lista di controllo di accettazione.
Se più repository condividono lo stesso nome di progetto, registrare la cartella di origine assoluta per ciascun candidato. Un clone realizzato dopo l’incidente potrebbe non avere le prove locali rilevanti anche quando contiene le stesse filiali remote. Al contrario, un clone personale più vecchio può preservare una storia utile. Confronta la disponibilità e il contenuto effettivi degli oggetti anziché dare per scontato che ogni clone sia intercambiabile a fini di ripristino.
Ispezionare i candidati storici in modo coerente
Impegnare genitori e cambiamenti dipendenti
Un suggerimento recuperato può includere un’intera sequenza di lavoro, mentre un commit isolato può dipendere da modifiche precedenti. Ispeziona la cronologia dei genitori e i file correlati. Ad esempio, l’implementazione di una funzionalità può richiedere un aggiornamento dello schema o un dispositivo di test da un altro commit. Il ripristino solo del file sorgente più riconoscibile può produrre un risultato incompleto anche se il commit recuperato stesso è autentico.
Conserva un riferimento di soccorso in un punto utile verificato e confronta la sequenza in uno spazio di lavoro controllato. Quindi decidere come il progetto attuale dovrebbe incorporarlo attraverso la normale revisione. Ciò separa l’accesso al lavoro storico dall’integrazione. Evita anche un altro reset distruttivo che scarta le modifiche attuali non correlate semplicemente perché la sequenza recuperata una volta rappresentava la punta del ramo.
Modifiche e identificatori ribasati
Un rebase può creare nuovi identificatori di oggetto per modifiche che assomigliano a commit precedenti. Pertanto, confronta le differenze effettive e il contesto circostante piuttosto che trattare un messaggio o un breve identificatore come prova completa. Confermare inoltre che un identificatore abbreviato si risolva in modo inequivocabile nel repository pertinente. Un candidato proveniente da un altro clone può richiedere un identificatore più lungo o un contesto di riferimento diverso per un’ispezione affidabile.
Mantieni documentata la fonte originale del candidato. Se due versioni implementano la stessa modifica logica in modo diverso, conservarle entrambe finché la revisione non determina la forma accettata. Il recupero non richiede la scelta del primo messaggio familiare. Il candidato più forte è quello che ripristina il comportamento e il contesto previsti pur rimanendo comprensibile e compatibile con il progetto attuale.
Copertura e conflitti delle scorte
Ispeziona cosa contiene effettivamente una scorta prima di applicarla. Le sue opzioni di creazione influiscono sulla visualizzazione dei contenuti non tracciati o ignorati. Confronta anche il suo stato di base con il lavoro attuale. Una scorta di un’altra attività può contenere frammenti utili insieme a modifiche non correlate. Preserva il candidato e utilizza uno stato di test controllato anziché applicarlo su un albero di lavoro occupato senza revisione.
Se si verificano conflitti, mantieni disponibili la scorta originale e la base di riferimento attuale. Una risoluzione dei conflitti è un nuovo lavoro che necessita di verifica, non di prova che le modifiche originali siano state restituite automaticamente. Registrare eventuali sezioni ricostruite. Ciò aiuta il revisore a distinguere la fonte recuperata dalle decisioni prese durante l’integrazione e impedisce che un’unione superficialmente pulita nasconda il comportamento perduto.
Trattare l’ispezione degli oggetti come una raccolta di prove
Gli oggetti pendenti possono non essere correlati
Un repository può contenere oggetti irraggiungibili derivanti da attività ordinarie che non hanno nulla a che fare con l’incidente. Ispeziona il contenuto effettivo prima di selezionarne uno. Un BLOB pendente può preservare il testo senza il nome file originale o il contesto del progetto. Un commit pendente può fornire una cronologia coerente. Questi risultati hanno un valore pratico diverso, quindi etichetta il risultato in base a ciò che hai effettivamente trovato.
Conservare l’archivio delle prove prima di qualsiasi fase di manutenzione o riparazione. Mantenere inoltre separati gli errori di integrità reale dai report informativi sugli oggetti non raggiungibili. L’esecuzione ripetuta di operazioni di scrittura finché l’output non appare più silenzioso può rimuovere materiale di ripristino utile senza ripristinare la destinazione. Un’indagine controllata di sola lettura fornisce un percorso più chiaro verso un riferimento di salvataggio verificato o un recupero limitato della sorgente parziale.
La sopravvivenza degli oggetti ha dei limiti
Le voci e gli oggetti di relog non costituiscono un archivio illimitato. La conservazione effettiva, la manutenzione e i cloni disponibili determinano ciò che rimane. Non promettere la guarigione solo perché l’incidente è recente. Ispezionare tempestivamente la fonte pertinente e conservarla. Se gli oggetti richiesti sono assenti ovunque disponibili, un messaggio di reflog da solo non può ricrearne l’intero contenuto.
A quel punto, identificare fonti alternative come cloni sopravvissuti autorizzati, patch registrate, cronologia dell’editor o backup di file indipendenti. Mantieni esplicito l’obiettivo dell’integrazione. Un’implementazione ricostruita può risolvere il problema dell’utente pur differendo dall’esatto commit perduto. Documentare tale distinzione piuttosto che produrre una richiesta di recupero dall’aspetto storico partendo da prove incomplete.
Convalidare e conservare un risultato di salvataggio
Testare il comportamento previsto
Confronta la sequenza recuperata con i requisiti effettivi dell’attività. Esamina i test, la configurazione e le risorse del progetto correlati. Quindi esegui la convalida mirata in un ambiente appropriato. Un successo nella costruzione è utile ma potrebbe non esercitare il comportamento perduto. Esamina anche qualsiasi risoluzione del conflitto o fonte ricostruita, perché si tratta di nuove decisioni stratificate sulla storia recuperata.
Mantenere la pubblicazione separata dall’accettazione locale. Non è necessario che un ramo di salvataggio verificato sostituisca immediatamente la cronologia remota condivisa. Utilizzare il normale flusso di lavoro di revisione e integrazione autorizzato del repository. Ciò protegge il lavoro più recente dei colleghi e impedisce che materiale locale incompleto o sensibile venga distribuito semplicemente perché un comando di ripristino ha avuto esito positivo.
Mantieni punti di ripristino coerenti
Dopo l’accettazione, conservare un riferimento significativo o un altro backup del repository supportato appropriato al flusso di lavoro. Proteggi anche importanti risorse non Git in modo indipendente. Testa un ripristino rappresentativo che includa lo stato del progetto di cui hai effettivamente bisogno. Una filiale remota, un reflog locale e una copia completa delle prove forniscono una copertura diversa; nessuno dovrebbe essere descritto come un backup universale di ogni sequenza di tasti e di file ignorati.
Documentare la fonte di salvataggio accettata e eventuali lacune rimanenti. Conservare le prove originali fino al termine della revisione. Ciò fornisce al futuro ricercatore un contesto sufficiente per distinguere la sequenza recuperata dai successivi cambiamenti di integrazione. Il risultato duraturo è uno stato di progetto coerente e testato con una provenienza comprensibile, piuttosto che una raccolta di identificatori di oggetti che nessuno sa come collegare al lavoro previsto.
Quando PandaOffice Drecov può aiutare
Una scansione dell’archivio può essere utile quando la directory del repository o i file di origine sono effettivamente assenti dall’archivio locale supportato. PandaOffice Drecov non ricrea il grafico di Git da alcuni frammenti di oggetti recuperati arbitrariamente né ripristina la cronologia eliminata di un server remoto. Controlla il supporto attuale e ispeziona i candidati effettivi. Preferire gli strumenti di ripristino nativi di Git quando il database degli oggetti rilevanti esiste ancora e può fornire una cronologia coerente.
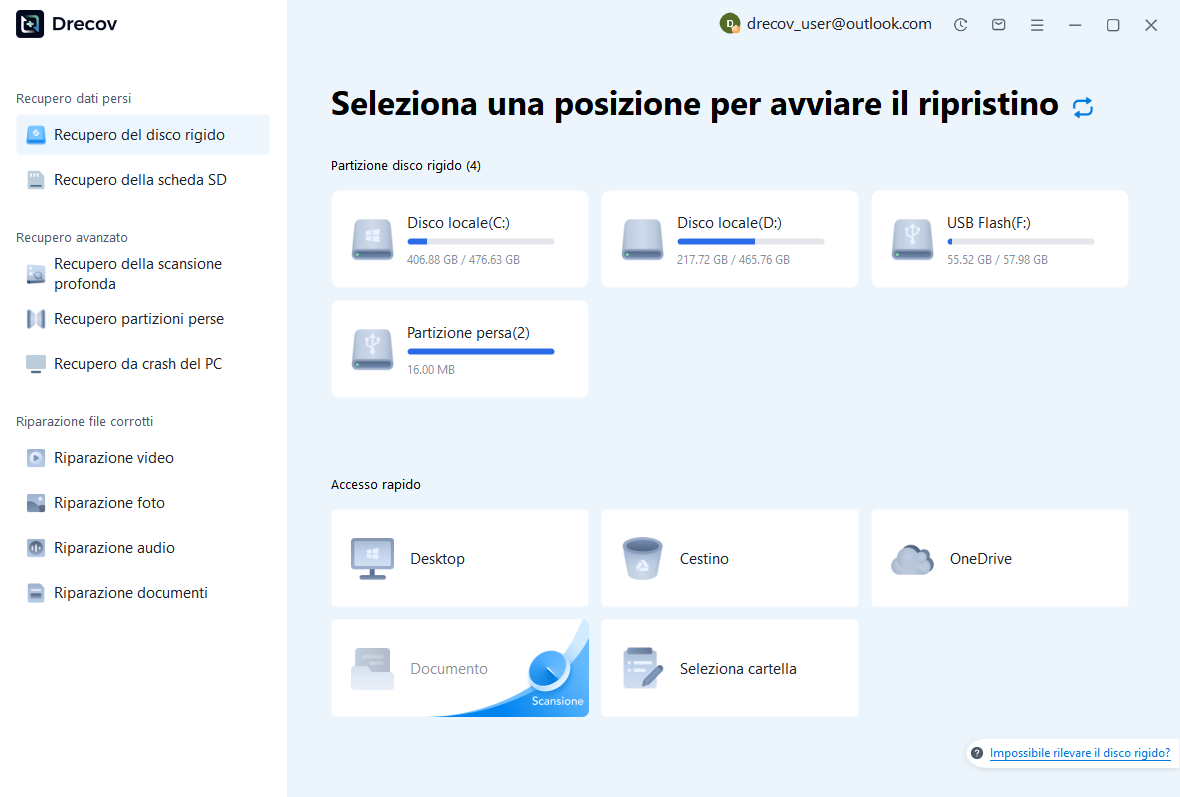
Passaggio 1: seleziona l’attuale spazio di archiviazione del repository
Identificare il disco che conteneva la directory di lavoro e i metadati Git rilevanti. Gli alberi di lavoro collegati possono posizionare i metadati altrove, quindi preserva la relazione. Evita nuove build, download di dipendenze o installazione di software di ripristino sullo spazio di archiviazione interessato. Se il dispositivo diventa instabile, interrompere le scansioni ripetute e valutarne le condizioni. Un clone integro su un altro disco può fornire una fonte più coerente rispetto a un ripristino di archiviazione frammentato.
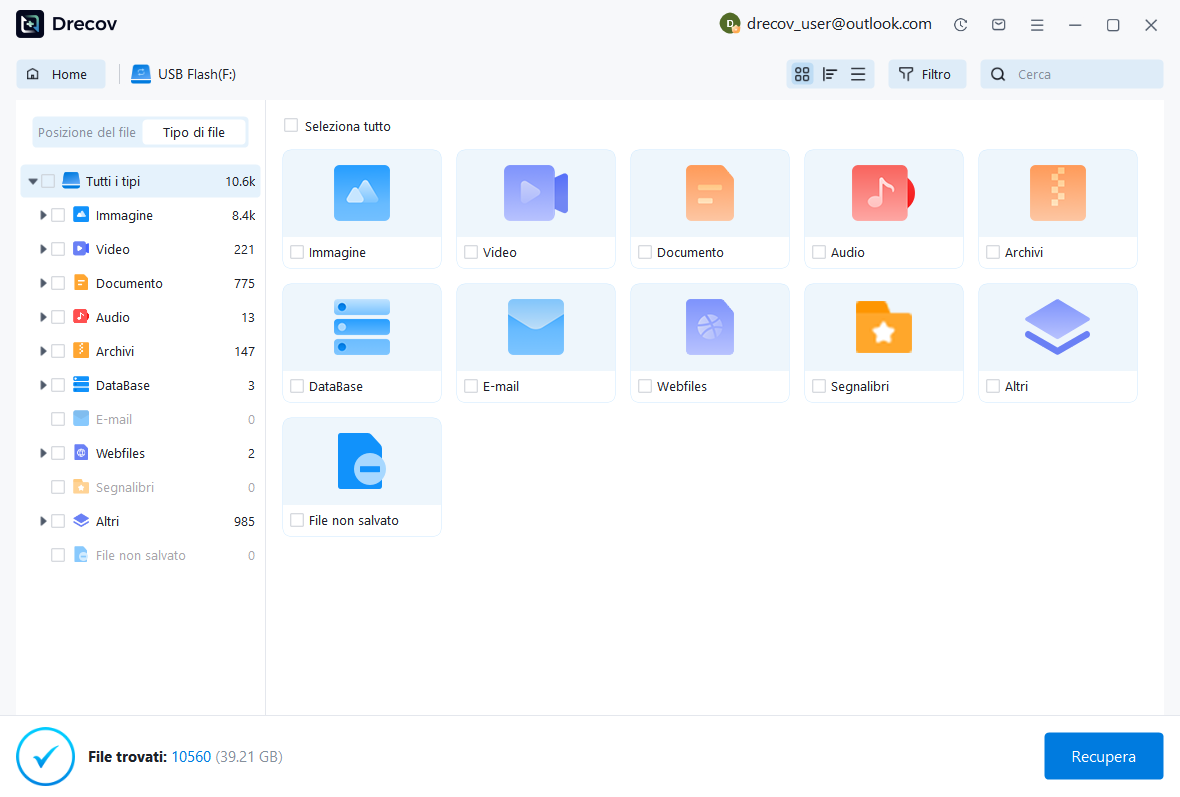
Passaggio 2: preservare il contesto completo del candidato
Utilizza i filtri disponibili per percorso, data, nome e formato. Recupera la struttura di directory pertinente ove possibile anziché selezionare solo i file di origine visibili. Conservare inoltre diverse copie plausibili del repository. Una cartella di origine può essere utile senza contenere la cronologia locale mancante, mentre i frammenti di metadati potrebbero non ricostruire un repository valido. Mantieni visibili queste limitazioni e registra l’origine di ciascun candidato.
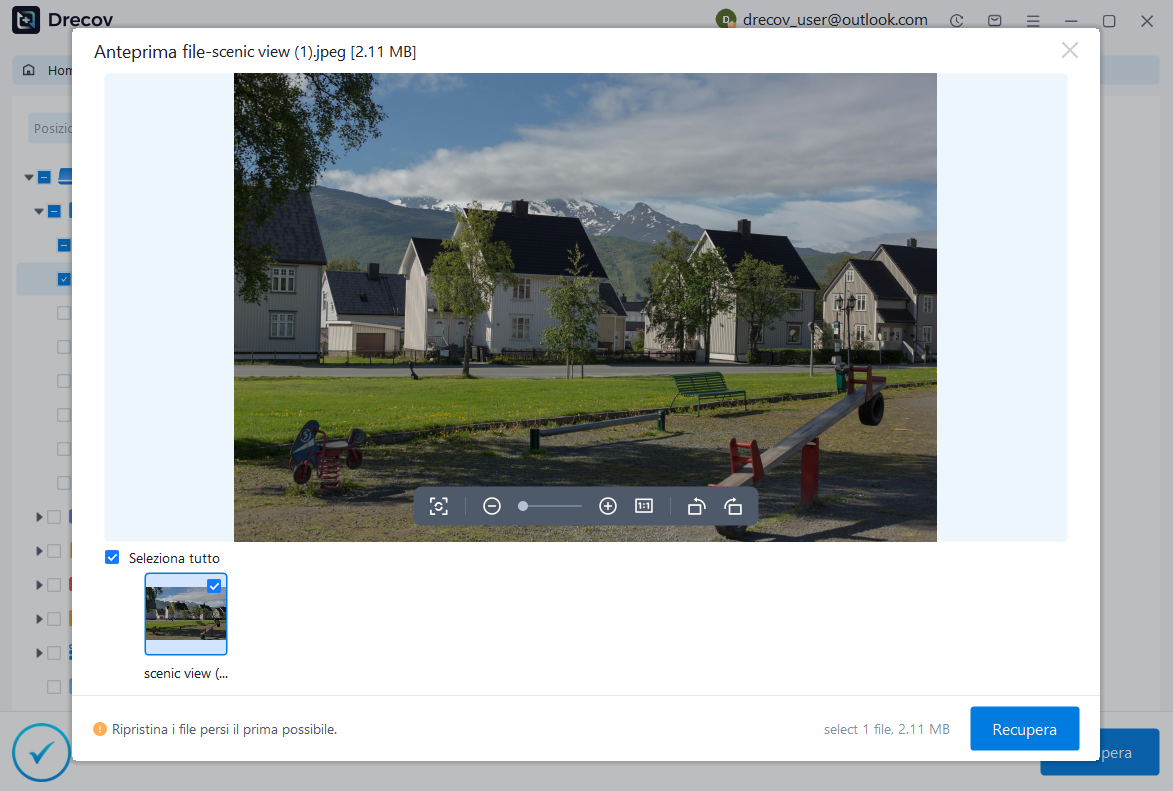
Passaggio 3: ripristina altrove ed esamina tramite Git
Salva i candidati su un diverso disco fisico integro. Controlla la licenza e visualizza in anteprima le limitazioni prima dell’acquisto. Quindi ispeziona le copie tramite Git appropriato e strumenti a livello di origine senza eseguire automaticamente il codice recuperato. Convalida separatamente la disponibilità degli oggetti e il contenuto del progetto. L’utilità di archiviazione fornisce file potenziali; L’ispezione Git stabilisce se sopravvive una cronologia di commit coerente e quale lavoro necessita ancora di ricostruzione.
Risorse di ripristino correlate
Esplora le opzioni di ripristino pertinenti: Recupero del disco rigido, Recupero hard disk esterno.
Per un altro caso di recupero e le relative verifiche pratiche, leggere la relativa guida al ripristino.
Controlla le indicazioni del fornitore per la versione installata: documentazione ufficiale di recupero 1, documentazione ufficiale di recupero 2, documentazione ufficiale di recupero 3, documentazione ufficiale di recupero 4.





